AMD Ungkap Kemampuan Gorgon Halo dengan Memori Terpadu untuk Pemrosesan AI Lokal

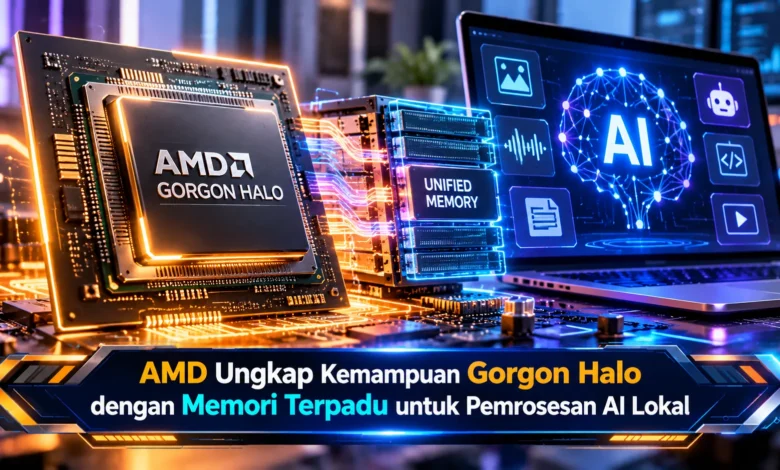
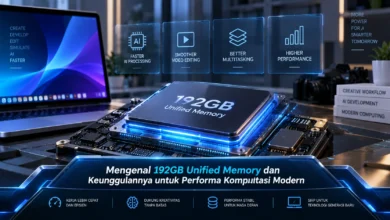
AMD kembali menjadi sorotan industri teknologi setelah mengungkap kemampuan Gorgon Halo, platform prosesor yang ditujukan untuk pemrosesan kecerdasan buatan secara lokal. Melalui jajaran Ryzen AI Max dan Ryzen AI Max PRO 400 Series, perusahaan memperkenalkan pendekatan komputasi yang menggabungkan CPU, GPU, NPU, serta memori terpadu berkapasitas besar. Konfigurasi tertingginya mendukung hingga 192GB RAM, dengan alokasi memori grafis mencapai 160GB untuk menangani model AI berukuran besar. Teknologi tersebut membuka peluang bagi pengembang dan perusahaan untuk menjalankan aplikasi AI tanpa selalu bergantung pada layanan cloud, sekaligus menawarkan fleksibilitas dalam mengelola data, biaya komputasi, dan kebutuhan perangkat profesional.
Inovasi Gorgon Halo Membawa Teknologi AI Berkapasitas Besar ke Komputer Pribadi
Perkembangan TEKNOLOGI AI modern menghadirkan perubahan terhadap pengembangan komputer berkinerja tinggi. Dengan menghadirkan keluarga prosesor terbaru, AMD meningkatkan potensi perangkat workstation untuk mendukung aplikasi generatif tanpa ketergantungan penuh pada cloud. Keluarga prosesor terbaru tersebut menggabungkan unit pemrosesan utama, kemampuan komputasi paralel, dan NPU khusus AI dalam satu rancangan perangkat keras. Pendekatan pemrosesan tersebut dirancang untuk menangani beban kerja kecerdasan buatan dengan dukungan memori berkapasitas besar. Ketika aplikasi AI dijalankan langsung di perangkat, jumlah RAM merupakan pertimbangan penting. Dengan mempertimbangkan kebutuhan tersebut, AMD mengutamakan arsitektur unified memory sebagai keunggulan utama platform.
Generasi prosesor terbaru tersebut menjadi pengembangan lanjutan dari keluarga Strix Halo. Kemajuan utama generasi ini adalah bertambahnya kapasitas memori. Pada generasi sebelumnya, kapasitas maksimum mencapai 128GB. Sementara itu, konfigurasi tertinggi menyediakan 192 gigabyte memori terpadu. Penambahan RAM tersebut memungkinkan alokasi memori lebih luas bagi sistem agen AI. Namun demikian, kapasitas yang tersedia bergantung pada model produk. Oleh sebab itu, pengembang dianjurkan memastikan kapasitas RAM yang dipasang sebelum merencanakan pemrosesan model besar.
Memori Terpadu 192GB Menjadi Keunggulan Gorgon Halo
Salah satu keunggulan penting Gorgon Halo adalah sistem memori terpadu yang memungkinkan CPU dan GPU mengakses kapasitas memori sistem. Memiliki pendekatan berlainan dibandingkan komputer dengan GPU diskret, sistem terpadu tersebut dapat mengurangi perpindahan data tertentu antara CPU dan GPU. Nilai tambahan sistem tersebut memiliki potensi besar ketika menggunakan aplikasi dengan kebutuhan memori tinggi. Ketika LLM digunakan, informasi numerik model membutuhkan ruang penyimpanan kerja. Melalui dukungan memori besar, pengguna memiliki kesempatan menjalankan beban komputasi yang sebelumnya sulit dijalankan pada PC biasa.


Berdasarkan spesifikasi resmi, sistem memungkinkan penggunaan ruang kerja GPU sebesar 160 gigabyte. Jumlah tersebut tidak menunjukkan adanya memori kartu grafis khusus sebesar 160GB. Dalam arsitektur terpadu, alokasi tersebut menggunakan pool RAM terpadu. Hal tersebut penting dipahami karena proses pendukung masih memerlukan alokasi memori. Ketika alokasi model terlalu besar, performa sistem dapat terpengaruh. Tidak kalah penting, kecepatan akses data juga memengaruhi jumlah token yang dihasilkan. Oleh sebab itu, sistem yang memiliki ruang besar tetap membutuhkan perangkat lunak teroptimasi.
Teknologi AMD Mendukung Inferensi Model Bahasa Besar Tanpa Cloud
Aspek menarik dari pengembangan Gorgon Halo adalah kemampuan menjalankan LLM dengan banyak parameter. Menurut AMD, sistem Gorgon Halo kelas atas memungkinkan penggunaan LLM berukuran melampaui 300B menggunakan representasi bobot empat bit. Spesifikasi tersebut menjadi pencapaian menarik bagi pengembang AI yang mengembangkan aplikasi tanpa selalu menggunakan server cloud. Meski jumlah parameternya tinggi, menjalankan model tidak sama dengan mendapatkan respons sangat cepat. Performa inferensi aktual ditentukan oleh kombinasi arsitektur model serta metode kompresi.
Teknik kuantisasi memiliki manfaat besar dalam menyesuaikan model dengan kapasitas perangkat. Jika bobot disimpan menggunakan banyak bit, model memerlukan alokasi RAM yang lebih tinggi. Sebagai gambaran, model 300 miliar parameter pada presisi 16-bit memerlukan kira-kira 600 gigabyte sebelum overhead. Jika dikompresi menjadi 4-bit, estimasi parameter murni menjadi sekitar 150 gigabyte. Sebagai catatan, file model biasanya membutuhkan informasi tambahan. Selain itu, sistem masih membutuhkan buffer komputasi. Dengan mempertimbangkan kebutuhan tersebut, ukuran file tidak boleh menjadi satu-satunya acuan.
Peran CPU Zen 5, GPU RDNA 3.5, dan NPU XDNA 2 pada Gorgon Halo
Selain memori terpadu, Gorgon Halo mengintegrasikan prosesor berbasis AMD Zen 5, pemroses grafis Radeon RDNA 3.5, dan akselerator neural XDNA 2. Rancangan pemrosesan tersebut memungkinkan pembagian pekerjaan berdasarkan kebutuhan aplikasi. Prosesor sentral menangani sistem operasi, sedangkan GPU dapat mempercepat perhitungan tensor. Sementara itu, NPU dirancang untuk menjalankan pekerjaan neural yang kompatibel. Berkat integrasi unit pemrosesan, pengembang dapat menyesuaikan metode pelaksanaan tugas. Namun demikian, tidak semua aplikasi otomatis memanfaatkan ketiganya.
Untuk perangkat Gorgon Halo berkapasitas maksimal, AMD menyediakan prosesor dengan maksimum 16 core, kapasitas pemrosesan grafis hingga 40 CU, dan unit AI berkapasitas maksimum 55 triliun operasi per detik. Spesifikasi tersebut ditujukan untuk pekerjaan kreatif dan teknis. Meski nilai komputasi terlihat tinggi, kapasitas operasi mentah tidak otomatis menunjukkan performa semua model bahasa. Dalam pemrosesan model besar, bandwidth RAM dan dukungan GPU perlu diperhatikan secara khusus. Karena itu, penilaian perangkat sebaiknya menggunakan hasil benchmark pada model yang relevan, bukan mengandalkan klaim performa teoritis.
Pengujian Gorgon Halo Menjadi Sorotan dalam Persaingan Komputer AI
Untuk memperlihatkan kemampuan platform, AMD membagikan data evaluasi pemrosesan AI. Rangkaian benchmark tersebut melibatkan beban kerja AI generatif seperti pemrosesan grafis berbasis AI dan inferensi model bahasa. Dalam hasil uji yang diumumkan, keunggulan performa bervariasi dari selisih performa kecil sekitar 1,1 kali hingga peningkatan maksimum 32,2 kali terhadap konfigurasi pesaing dalam pengujian. Perlu dicermati, data performa merupakan klaim berdasarkan skenario perusahaan. Karena itu, angka tertinggi tidak menjamin setiap pekerjaan memperoleh percepatan serupa.
Dalam beberapa pengujian, AMD menggunakan ComfyUI untuk pemrosesan gambar generatif. Perusahaan juga memakai model terkompresi dengan dukungan Unsloth pada sejumlah beban kerja AI. Jenis perangkat lunak pengujian turut menentukan hasil benchmark. Di samping pemilihan model, jumlah token masukan berpotensi mengubah latensi generasi token. Ketika jumlah token meningkat besar, respons berpotensi menjadi lebih lambat meskipun perangkat mampu menjalankan inferensi. Oleh karena itu, pengembang sebaiknya melakukan benchmark sesuai model yang digunakan sebelum menyimpulkan keunggulan performa.
Manfaat Memori Besar AMD bagi Developer serta Perusahaan
Penerapan yang paling relevan Gorgon Halo adalah pembuatan sistem kecerdasan buatan di perangkat. Melalui platform tersebut, pengembang berpotensi menjalankan model bahasa besar langsung pada perangkat yang dikelola sendiri. Kemampuan tersebut berpotensi mendukung pengujian aplikasi tanpa ketergantungan penuh pada cloud. Sebagai contoh, perusahaan dapat mencoba agen AI berbasis data organisasi yang menggunakan informasi tanpa selalu mengirimnya ke layanan eksternal. Walaupun proses dilakukan di perangkat, perlindungan data masih membutuhkan perhatian. Perangkat lunak inferensi mungkin memiliki koneksi jaringan, sehingga administrator sebaiknya meninjau alur data.
Selain model bahasa, Gorgon Halo berpotensi membantu penyusunan sistem kecerdasan buatan bertahap. Pada arsitektur agen, pekerjaan dapat melibatkan sejumlah komponen. Sebagai ilustrasi, aplikasi mungkin menganalisis berkas referensi, kemudian menentukan langkah lanjutan berdasarkan informasi yang tersedia. Ruang kerja komputasi yang besar dapat membantu menyimpan model serta data dalam satu sistem. Namun demikian, aplikasi kompleks harus mempertimbangkan pembagian pekerjaan yang tepat. Sebagai pertimbangan tambahan, tindakan otomatis harus diawasi agar kesalahan tidak diteruskan ke tahap berikutnya.
Kesimpulan: Memori Terpadu 192GB Menjadi Nilai Penting Gorgon Halo
Pengembangan platform AI lokal generasi terbaru AMD menjadi perkembangan menarik dalam pengembangan sistem AI pada perangkat pribadi. Berkat penggunaan memori terpadu hingga 192GB, dukungan memori GPU hingga 160GB, serta arsitektur pemrosesan AMD yang terintegrasi, generasi prosesor terbaru ini berpotensi mendukung pengolahan AI generatif. Potensi pemrosesan model sangat besar menggunakan quantization 4-bit membuka pilihan menarik bagi pengembang profesional. Meski kapasitas komputasinya tinggi, hasil inferensi tetap perlu diuji berdasarkan dukungan perangkat lunak dan bandwidth memori. Dengan mempertimbangkan berbagai faktor, calon pengguna sebaiknya memilih konfigurasi berdasarkan beban kerja. Menurut Anda, seberapa penting kemampuan menjalankan model besar tanpa cloud? Silakan bagikan pendapat Anda mengenai masa depan AI lokal.