AMD Ungkap Kemampuan Gorgon Halo dengan Memori Terpadu untuk Pemrosesan AI Lokal

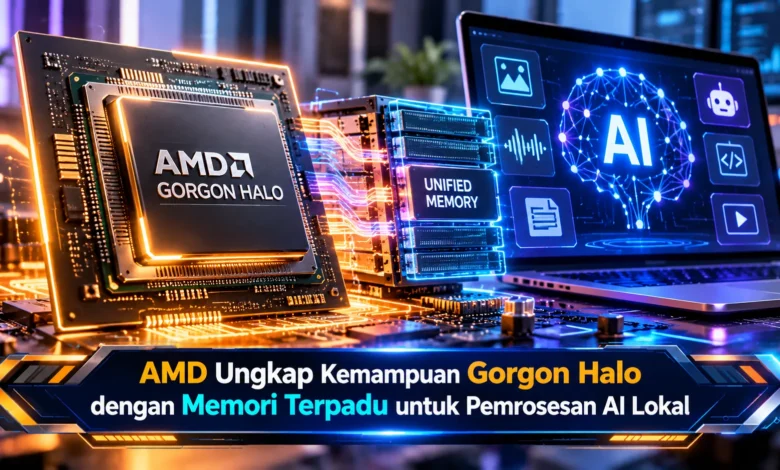
AMD kembali menjadi sorotan industri teknologi setelah mengungkap kemampuan Gorgon Halo, platform prosesor yang ditujukan untuk pemrosesan kecerdasan buatan secara lokal. Melalui jajaran Ryzen AI Max dan Ryzen AI Max PRO 400 Series, perusahaan memperkenalkan pendekatan komputasi yang menggabungkan CPU, GPU, NPU, serta memori terpadu berkapasitas besar. Konfigurasi tertingginya mendukung hingga 192GB RAM, dengan alokasi memori grafis mencapai 160GB untuk menangani model AI berukuran besar. Teknologi tersebut membuka peluang bagi pengembang dan perusahaan untuk menjalankan aplikasi AI tanpa selalu bergantung pada layanan cloud, sekaligus menawarkan fleksibilitas dalam mengelola data, biaya komputasi, dan kebutuhan perangkat profesional.
AMD Ryzen AI Max 400 Series Membuka Peluang Baru bagi Pemrosesan AI Lokal
Transformasi TEKNOLOGI AI modern semakin meningkatkan permintaan sistem pemrosesan lokal. Melalui platform Gorgon Halo, AMD meningkatkan potensi perangkat workstation untuk memproses kecerdasan buatan secara mandiri. Keluarga prosesor terbaru tersebut menyatukan unit pemrosesan utama, kemampuan komputasi paralel, dan unit pemrosesan neural dalam platform prosesor terintegrasi. Kombinasi tersebut bertujuan membantu menjalankan beban kerja kecerdasan buatan dengan dukungan memori berkapasitas besar. Pada penggunaan profesional, kapasitas memori sering menjadi kebutuhan mendasar. Dengan mempertimbangkan kebutuhan tersebut, AMD mengutamakan arsitektur unified memory sebagai komponen strategis produk.
Generasi prosesor terbaru tersebut hadir sebagai penyempurnaan dari arsitektur Ryzen AI Max sebelumnya. Salah satu peningkatan penting adalah perluasan ruang kerja terpadu. Pada generasi sebelumnya, RAM terpadu tersedia hingga 128GB. Sementara itu, kapasitas memori meningkat hingga 192GB. Peningkatan tersebut memberikan ruang lebih besar bagi aplikasi generatif. Walaupun kapasitas meningkat, setiap perangkat tidak otomatis memiliki RAM maksimal. Karena itu, pengguna perlu memeriksa spesifikasi perangkat sebelum merencanakan pemrosesan model besar.
Memori Terpadu 192GB Menjadi Keunggulan Gorgon Halo
Salah satu keunggulan penting Gorgon Halo adalah penggunaan RAM bersama yang mengintegrasikan akses memori untuk komponen pemrosesan kapasitas memori sistem. Memiliki pendekatan berlainan dibandingkan perangkat dengan VRAM khusus, sistem terpadu tersebut memungkinkan pertukaran informasi lebih langsung antara komponen utama dan grafis. Keuntungan tersebut dapat membantu ketika menjalankan model AI berukuran besar. Pada inferensi model bahasa, bobot model membutuhkan ruang penyimpanan kerja. Dengan kapasitas hingga 192GB, sistem dapat menampung lebih banyak parameter.


Berdasarkan spesifikasi resmi, arsitektur tersebut mendukung pembagian hingga 160GB memori untuk GPU. Besarnya alokasi memori tersebut berbeda dari kapasitas VRAM dedicated pada GPU diskret. Sebaliknya, alokasi tersebut menggunakan pool RAM terpadu. Karakteristik tersebut perlu diperhatikan karena proses pendukung masih memerlukan alokasi memori. Jika memori hampir penuh, pengelolaan proses dapat menjadi kurang efisien. Tidak kalah penting, kemampuan transfer informasi juga memengaruhi kecepatan inferensi. Dengan mempertimbangkan faktor tersebut, sistem yang memiliki ruang besar tetap membutuhkan perangkat lunak teroptimasi.
Kemampuan Ryzen AI Max PRO 400 Series untuk Menjalankan LLM Lokal
Salah satu kemampuan yang menjadi perhatian adalah dukungan terhadap model AI berukuran besar. Dalam informasi produknya, platform dengan memori maksimal memungkinkan penggunaan model bahasa dengan jumlah parameter di atas 300 miliar menggunakan representasi bobot empat bit. Spesifikasi tersebut memberikan pilihan tambahan bagi organisasi teknologi yang membutuhkan sistem inferensi mandiri. Walaupun kemampuan tersebut menjanjikan, kemampuan memuat parameter bukan jaminan menghasilkan token dengan latensi rendah. Performa inferensi aktual ditentukan oleh kombinasi jumlah token konteks serta metode kompresi.
Metode kompresi bobot menjadi komponen utama dalam menyesuaikan model dengan kapasitas perangkat. Dalam representasi numerik berukuran besar, model memerlukan alokasi RAM yang lebih tinggi. Untuk ilustrasi teknis, LLM dengan tiga ratus miliar bobot pada presisi 16-bit memerlukan kira-kira 600 gigabyte sebelum overhead. Apabila setiap bobot direpresentasikan dengan empat bit, ukuran dasar bobot dapat mendekati 150GB. Perlu dipahami, format quantization nyata memerlukan metadata. Selain itu, proses inferensi menggunakan buffer komputasi. Oleh sebab itu, ukuran file tidak boleh menjadi satu-satunya acuan.
Arsitektur AMD Menggabungkan Berbagai Unit Pemrosesan AI
Di samping dukungan RAM besar, Gorgon Halo memadukan unit komputasi utama generasi Zen 5, pemroses grafis Radeon RDNA 3.5, dan unit pemrosesan AI khusus berbasis XDNA 2. Kombinasi tersebut mendukung pengelolaan komputasi berdasarkan karakter beban kerja. Unit pemrosesan utama menangani sistem operasi, sedangkan GPU berperan besar dalam inferensi model AI. Sementara itu, NPU dirancang untuk menjalankan pekerjaan neural yang kompatibel. Berkat integrasi unit pemrosesan, pengembang dapat menyesuaikan sumber komputasi sesuai kebutuhan. Namun demikian, dukungan perangkat lunak tetap menentukan penggunaan.
Dalam model Ryzen AI Max PRO 400 Series kelas atas, AMD menyediakan dukungan pemrosesan utama enam belas inti, grafis terintegrasi dengan 40 unit komputasi, dan unit AI berkapasitas maksimum 55 triliun operasi per detik. Rancangan perangkat keras tersebut ditujukan untuk pekerjaan kreatif dan teknis. Walaupun angka TOPS menunjukkan kapasitas teoritis, kapasitas operasi mentah tidak otomatis menunjukkan hasil generasi token. Ketika menjalankan jaringan saraf berparameter tinggi, efisiensi memori serta runtime perlu diperhatikan secara khusus. Karena itu, calon pengguna disarankan mempertimbangkan pengujian kecepatan token nyata, bukan mengandalkan klaim performa teoritis.
Pengujian Gorgon Halo Menjadi Sorotan dalam Persaingan Komputer AI
Dalam menjelaskan performa perangkat, AMD membagikan data evaluasi pemrosesan AI. Evaluasi performa ini mencakup beban kerja AI generatif seperti pemrosesan grafis berbasis AI dan pengolahan LLM. Menurut AMD, hasil perbandingan berbeda menurut tugas dari sekitar 1,1 kali hingga 32,2 kali terhadap sistem lain yang menjadi acuan. Perlu dicermati, angka tersebut berasal dari benchmark yang dipilih AMD. Karena itu, hasil tersebut tidak boleh dianggap berlaku untuk semua aplikasi.
Berdasarkan evaluasi tertentu, AMD memanfaatkan ComfyUI untuk pembuatan visual berbasis AI. Perusahaan juga memakai model terkompresi dengan dukungan Unsloth pada sejumlah beban kerja AI. Jenis perangkat lunak pengujian turut menentukan kecepatan inferensi. Selain itu, panjang konteks percakapan memiliki dampak terhadap kebutuhan RAM tambahan. Pada konteks sangat panjang, respons berpotensi menjadi lebih lambat meskipun perangkat mampu menjalankan inferensi. Dengan demikian, calon pembeli perlu mencari hasil evaluasi pada pekerjaan nyata sebelum menyimpulkan keunggulan performa.
Gorgon Halo Membantu Pengembangan AI Lokal dan Sistem Agen Digital
Penerapan yang paling relevan Gorgon Halo adalah pengujian model bahasa tanpa server eksternal. Dengan dukungan memori terpadu, pengembang berpotensi menjalankan model bahasa besar langsung pada workstation pribadi. Fleksibilitas pemrosesan tersebut berpotensi mendukung pengelolaan data dalam lingkungan lokal. Pada kebutuhan pengembangan, perusahaan dapat mencoba sistem pencarian informasi yang menggunakan informasi tanpa selalu mengirimnya ke layanan eksternal. Meski model berjalan tanpa cloud, privasi tidak otomatis terjamin. Sistem yang digunakan mungkin memiliki koneksi jaringan, sehingga izin dan konfigurasi perlu diperiksa.
Tidak hanya mendukung pemrosesan teks, Gorgon Halo berpotensi membantu penyusunan sistem kecerdasan buatan bertahap. Pada arsitektur agen, beberapa proses dapat berjalan berurutan. Sebagai ilustrasi, sistem berpotensi memeriksa data pendukung, kemudian menghasilkan rekomendasi berdasarkan instruksi pengguna. Ruang kerja komputasi yang besar berpotensi memungkinkan pemuatan beberapa komponen pemrosesan. Namun demikian, aplikasi kompleks harus mempertimbangkan pembagian pekerjaan yang tepat. Di samping kebutuhan performa, hasil setiap agen perlu diverifikasi agar kesalahan tidak diteruskan ke tahap berikutnya.
Kesimpulan: Teknologi Ryzen AI Max 400 Series Mendukung Komputasi AI Masa Depan
Pengembangan platform AI lokal generasi terbaru AMD menjadi perkembangan menarik dalam industri komputer berkinerja tinggi. Berkat penggunaan memori terpadu hingga 192GB, dukungan memori GPU hingga 160GB, serta perpaduan komputasi umum, grafis, dan akselerator AI, generasi prosesor terbaru ini berpotensi mendukung inferensi model bahasa besar. Kemampuan menjalankan model di atas 300B parameter menggunakan quantization 4-bit memberikan nilai penting bagi peneliti AI. Namun demikian, hasil inferensi tetap perlu diuji berdasarkan jenis pekerjaan dan konfigurasi perangkat. Dengan mempertimbangkan berbagai faktor, pengembang perlu mengevaluasi konfigurasi berdasarkan beban kerja. Dari sudut pandang Anda, seberapa penting kemampuan menjalankan model besar tanpa cloud? Silakan bagikan pendapat Anda mengenai pemanfaatan memori terpadu pada komputer generasi terbaru.