Recursive Rilis Flint, Model AI Coding Terbuka yang Bisa Dijalankan Secara Lokal

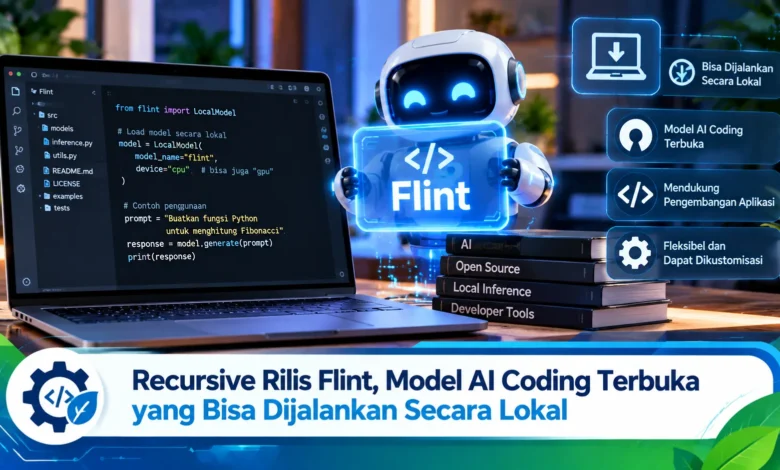
Perusahaan kecerdasan buatan Recursive memperkenalkan Flint pada 21 Oktober 2026 sebagai model AI coding terbuka yang dirancang untuk membantu pengembang menulis, memperbaiki, dan menguji kode secara lokal. Model ini menggunakan arsitektur Mixture-of-Experts dengan 39,8 miliar parameter, tetapi hanya mengaktifkan sekitar 2,5 miliar parameter untuk setiap token yang diproses. Pendekatan tersebut memungkinkan penggunaan komputasi yang lebih efisien dibandingkan model padat berukuran serupa. Dengan dukungan perangkat Apple Silicon dan GPU NVIDIA, Flint menawarkan alternatif bagi developer yang mengutamakan kecepatan, privasi, serta kontrol terhadap lingkungan pengembangan. Kehadirannya turut memperluas pilihan TEKNOLOGI AI coding yang dapat dijalankan tanpa selalu bergantung pada layanan cloud.
Mengenal Recursive Flint sebagai Model AI Coding Terbuka
Recursive menghadirkan Flint sebagai sistem kecerdasan buatan yang berfokus pada pengembangan perangkat lunak. Berbeda dari chatbot yang mengutamakan percakapan umum, Flint dirancang membantu proses pemrograman yang kompleks. Fungsi utamanya berkaitan dengan pemahaman struktur proyek, perbaikan bug, implementasi fitur, dan penulisan pengujian otomatis. Berkat rancangan khusus tersebut, pengembang dapat memanfaatkan AI sebagai pendamping kerja. Walaupun difokuskan pada coding, hasil model tetap membutuhkan pemeriksaan manusia. Prinsip pengawasan ini mendukung penerapan AI secara bertanggung jawab.
Karakteristik yang membedakan Flint adalah kemampuan mengunduh dan menjalankan model secara mandiri. Recursive merilis Flint dengan lisensi Apache 2.0 yang memungkinkan integrasi dalam proyek yang sesuai ketentuan lisensi. Dengan ketersediaan tersebut, model dapat dioperasikan melalui infrastruktur lokal. Kemampuan tersebut relevan untuk organisasi dengan kebutuhan pengendalian data. Walaupun bobot tersedia secara terbuka, penggunaan Flint tetap memerlukan perangkat keras yang sesuai. Selain itu, penggunaan layanan tambahan dapat memengaruhi privasi. Berkat pemahaman tersebut, pengembang dapat menyesuaikan penerapan sesuai kebutuhan.
Teknologi Model AI 40 Miliar Parameter yang Efisien
Flint menggunakan Mixture-of-Experts atau MoE yang dirancang mengurangi kebutuhan komputasi setiap token. Dalam konfigurasi lengkapnya, Flint menyimpan hampir 40 miliar parameter. Meskipun ukurannya besar, pemrosesan setiap token melibatkan kurang lebih 2,5 miliar parameter. Perbedaan tersebut menjadi alasan penting di balik efisiensi model. Dalam model dense, sebagian besar parameter biasanya ikut dihitung pada setiap token. Sementara itu, mekanisme pemilihan expert menentukan jalur komputasi. Melalui rancangan tersebut, inferensi menjadi lebih efisien pada perangkat yang mendukung.
Di luar pengelolaan parameter, Flint mendukung kapasitas konteks hingga 262.144 token. Kapasitas tersebut mendukung penyertaan riwayat pekerjaan dalam jumlah besar. Dalam penggunaan praktis, informasi dokumentasi proyek dapat disertakan bersama kode. Walaupun kapasitas konteks besar, model belum tentu menganalisis seluruh informasi dengan kualitas sama. Untuk menjaga efektivitas, pengembang dianjurkan memberikan instruksi terstruktur. Selain itu, konteks perlu disesuaikan dengan masalah yang sedang dikerjakan. Pendekatan tersebut mengurangi risiko model kehilangan fokus.
Kecepatan Flint pada Apple Silicon dan GPU NVIDIA
Recursive mengembangkan berbagai konfigurasi inferensi agar Flint dapat digunakan pada perangkat Apple Silicon. Menurut hasil benchmark Recursive, Flint mencapai kecepatan di atas 125 token per detik pada perangkat M4 Pro. Dalam pengujian menggunakan sistem grafis NVIDIA, kecepatan lebih dari 150 token per detik juga dilaporkan pada konfigurasi perangkat yang sesuai. Hasil pengujian tersebut memberikan gambaran kemampuan inferensi lokal. Meski hasilnya menarik, hasil dapat berubah menurut jumlah token konteks. Oleh sebab itu, angka benchmark tidak seharusnya dianggap sebagai jaminan universal.
Untuk mempermudah penggunaan, Flint didistribusikan melalui varian presisi berbeda. Salah satu pilihannya adalah BF16 yang mempertahankan representasi parameter berpresisi 16-bit. Untuk mengurangi kebutuhan memori, Recursive menyediakan checkpoint quantization seperti NVFP4 dan GGUF. Pilihan quantization ini bertujuan mengurangi penggunaan memori. Namun perlu diperhatikan, performa dapat berbeda berdasarkan presisi model. Untuk memilih konfigurasi yang sesuai, pengguna perlu memeriksa kapasitas memori. Melalui pemilihan versi yang tepat, proses inferensi dapat berjalan lebih efisien.
Langkah Awal Mengintegrasikan Model Flint ke Alur Kerja Coding
Metode yang dapat dipertimbangkan untuk mengoperasikan model AI Flint adalah menjalankan model melalui runtime Ollama. Dalam ekosistem model AI lokal, Ollama menjadi runtime yang mempermudah pengelolaan model lokal. Sesudah lingkungan lokal dipersiapkan, pengembang bisa menjalankan jendela perintah. Instruksi terminal ollama run flint memulai penggunaan Flint melalui Ollama. Ketika model selesai dimuat, developer bisa mengajukan pertanyaan tentang kode. Meski proses penggunaan dipermudah, interaksi terminal biasa tidak selalu menyediakan akses langsung ke seluruh repository.
Di luar penggunaan runtime tersebut, Flint memiliki integrasi dengan berbagai perangkat lunak AI. Ekosistem yang mendukung Flint mencakup SGLang, Unsloth, serta llama.cpp. Sebagai dukungan khusus, Recursive mengembangkan mesin inferensi lokal bernama rec. Runtime tersebut ditujukan untuk perangkat Apple Silicon tertentu. Dalam kebutuhan agen coding, model mendukung penggunaan melalui sistem agen seperti OpenHands. Berkat penggunaan perangkat lunak pendamping, model dapat diberikan kemampuan membaca file dan menjalankan tools. Perlu diingat, izin akses file dan terminal harus dikendalikan. Pengawasan tersebut menjaga keamanan repository dan lingkungan kerja.
Benchmark Recursive Flint dalam Tugas Agentic Coding
Flint dioptimalkan untuk menangani pekerjaan pemrograman yang memerlukan beberapa langkah. Dalam skenario pengembangan, pengembang dapat meminta model menganalisis bug. Melalui integrasi agen, sistem bisa membaca file terkait dan menyarankan perubahan sebelum solusi dievaluasi menggunakan proses validasi. Untuk pekerjaan pengembangan lainnya, Flint mendukung penyusunan fungsi baru serta menyusun skenario pemeriksaan kode. Penggunaan model dalam beberapa tahapan berpotensi mengurangi pekerjaan berulang. Namun demikian, hasil tetap harus diperiksa secara kritis. Proses validasi ini membantu menjaga keandalan perangkat lunak.
Sebagai bagian dari peluncuran Flint, Recursive menampilkan skor evaluasi pemrograman. Untuk benchmark tugas terminal, Flint mencatat hasil 54,9 persen. Pada evaluasi lainnya, hasil SWE-bench Pro v2 mencapai 89,7 persen, sedangkan pengujian SWE-bench Verified menghasilkan 74,2 persen. Pencapaian benchmark ini berasal dari pengujian yang dilaporkan Recursive. Untuk melakukan perbandingan yang tepat, konfigurasi runtime perlu diperhatikan. Selain itu, kemampuan pada proyek tertentu dapat berbeda. Berdasarkan keterbatasan evaluasi, pengujian langsung tetap diperlukan.
Penutup: Peluang Model AI Terbuka dalam Pengembangan Perangkat Lunak
Kehadiran model AI coding Flint menunjukkan kemajuan pemanfaatan AI untuk pemrograman. Melalui penggunaan sekitar 2,5 miliar parameter aktif, Flint menawarkan pemrosesan yang lebih hemat komputasi. Kapasitas hingga 262 ribu token serta kompatibilitas terhadap sejumlah platform inferensi memberikan fleksibilitas dalam penggunaan. Sebagai keunggulan penting, dukungan ekosistem open-weight memberikan ruang pengembangan komunitas. Meski kemampuan model terus berkembang, keamanan penggunaan agen perlu diperhatikan. Dalam transformasi TEKNOLOGI perangkat lunak, model lokal seperti Flint menawarkan alternatif terhadap layanan cloud. Menurut Anda, seberapa penting privasi repository dalam memilih model AI? Mari sampaikan pengalaman menggunakan AI coding lokal.